
Netflix 的 Eyeline Studios:生成式 AI 只能做到 60%,剩下 40% 才是真功夫
这个月一场视效会议上最有用的一句话,是一句拒绝。
「我们不是靠写提示词一路 prompt 出镜头和电影的。我们不是干这个的。」说这话的是 Mohsen Mousavi,Netflix 旗下特效公司 Eyeline Studios 负责虚拟先驱技术的副总裁,当时在都灵的 View Conference 上发言。他的履历里有《权力的游戏》最终季,所以这句拒绝并不是对生成模型的能力缺乏想象,而是在说明:真正的工作到底在哪儿。
他对这条边界的估计才是有意思的地方:生成模型大概能把一个项目推进到 60% 到 70%。而走到 100%,才是最要紧的。
所谓「混合制作」,在实践中是什么意思
Eyeline 的方法不是「把镜头生成出来」,而是三方混合:实拍、传统视效、生成式工具,而且这个配比是按单个镜头定的,不是按整个项目定的。
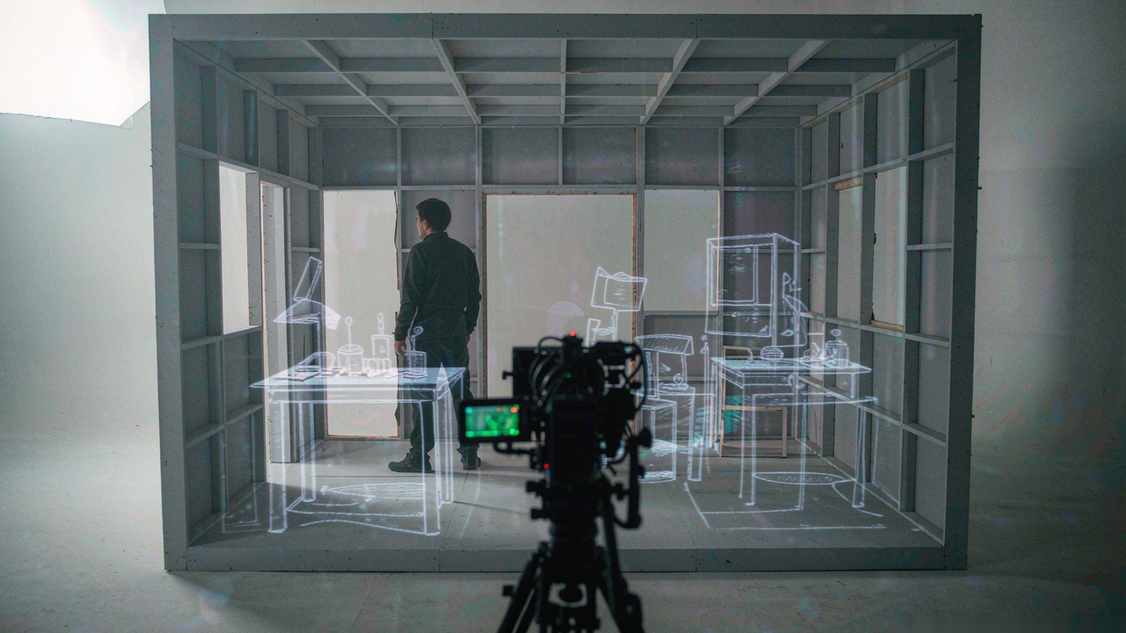
流程在开机之前就开始了。一个生成式美术部门会和传统美术师并行探索设计。接下来是真正扛大梁的技术:局部布景。演员在部分搭建的实体布景上表演,打光相对平,拍完之后再重建环境和光照,而原始的表演完整保留。
Mousavi 把这称作传统美术部门的延伸,而不是替代。这个说法是有实质作用的。美术部门的工作一直是决定摄影机看到什么;Eyeline 做的事情,是把其中一部分决定挪到了制作流程的更后面。
上面还叠了一层体积捕捉。在一个地点拍的素材可以被转换成另一个环境,而其中一些环境完全没有绿幕。「它让我们在拍完表演之后,同时拥有打光的自由和机位的自由,」Mousavi 说,同时补了一句前提:演员的身份和表演必须在这个过程里活下来。
两个项目,两种不同的问题
Brazil '70: The Third Star讲的是 1970 年国家队世界杯夺冠的故事。这部戏里,Eyeline 要让体育场坐满观众,而且这些观众得有情绪反应,不能看起来像贴图阵列。解决方案不是某一项技术:实拍的群演素材、sprites、传统 CG、生成式方法,一层层叠上去。Mousavi 的说法是预算层面的,不是艺术层面的——同样的活儿用传统视效做,「在那个预算里会非常、非常难完成」。
The American Experiment是一部五集历史纪录片,工作要安静得多:背景延展,加上生成式的尘土,再和实拍素材合成。尘土是个好例子,能说明这项技术真正强在哪儿。它是体积的,在年代感街景里无处不在,要模拟得让人信服很贵,而观众里没人会去查证一颗粒子。
Eyeline 还演示了在保留表演本身的前提下改变演员的视觉年龄,以及一支研究短片,讲的是拍摄之后调整机位和光照。负责 Eyeline GenFX 团队的 James Rustad 在釜山向观众给出了Brazil '70的量级:超过 1,300 个 VFX 镜头,45 位艺术家,四阶段流程——setup、narrative、look、delivery——并且刻意把人的叙事判断放在实验和收尾之间。
诚实的那部分:流体
会议演讲通常都以最强的 demo 收尾。这一场偏偏把最弱的也放了进来,而且是故意的。
Eyeline 正在做可控的生成式流体,Mousavi 对现状说得很直接:这些模拟不是确定性的,非常难控制。目标是能对速度、黏度和湍流做关键帧控制,还能在不破坏底层模拟的情况下加上泡沫或水花。
然后他说了一句只有真正干过视效的人才会说的话:在视效里,你常常真正想做的是把流体的物理规律打断。真实的水不够戏剧化。需要的不是物理准确,而是「可被导演的不准确」。这跟文生视频模型优化的目标是完全两回事,也解释了为什么这家工作室自己在造工具,而不是去 prompt 别人的。
其他展示的研究包括:把一次 Gaussian-splat 三维捕捉从冬天改成秋天,AI 辅助的人物表演重打光,以及尝试用单机位录制素材搭出一个可漫游的 4D 场景。为了训练重打光系统,Eyeline 用了一套 40 台同步的 RED V-Raptor 摄影机阵列,另外也做了更便携的捕捉设备。
没人拿来演示的取舍:平光与视线
局部布景是对一个很古老的约束的巧妙反转。传统做法是先搭好布景,让摄影机有真实的东西可拍,再按照故事去打光。Eyeline 把顺序倒过来:先用相对平、均匀的光拍下表演,然后再围绕它重建整个世界。
平光是代价。它是刻意拍得「不好看」的,因为一旦把有意思的光打进了素材,等你替换环境时它就变成麻烦——演员脸上已经有一道来自窗户的硬阴影,而那扇窗后来根本不存在了,你没法凭空在那里放一盏灯。拍平了,表演就还能用,而所有打光的决定都被推到下游,推到还能改的地方。
推不到下游的,是表演本身。Eyeline 在这点上说法始终一致:演员的身份和表演必须活下来。重建出来的环境救不了一条穿帮的 take——演员当时盯着棍子上的网球,而那点痕迹留在了画面上。这门技术买到的是打光和机位的自由,不是免于导演的自由。
这也是为什么这家工作室一直强调自己是美术部门的延伸,而不是替代。总得有人先决定这个房间长什么样,之后才谈得上把它换掉。
为什么 60/70 这个数字就是全部故事
想一想在专业后期里,最后那 30% 是由什么构成的:一个镜头内的时间一致性、能撑过 4K 完成的分辨率、高动态范围,以及摄影指导能说一句「左边再暗一点,窗户的光应该更晚一点」,然后在周四,可重复地拿到这个结果。
生成模型在前 60% 里强得离谱,因为前 60% 正是「新奇」待的地方。它们在最后 30% 上很弱,因为最后 30% 是「一致性」待的地方,而一致性恰恰是采样的反面。
这也是为什么当被问到「你们用哪些基础模型」,这家工作室的答案是耸耸肩。Mousavi 说大部分工作基于他们自己的研究和自己的模型,外加外部合作和专门采集的训练数据。模型是最容易租到的部分。捕捉阵列、训练数据,以及那套让一个镜头可以被重复做出来的流程,不是。
行业该注意的那部分
Netflix 在七月表示,大约有 300 部作品用过某种生成式 AI。它还收购了 Ben Affleck 的电影技术公司 InterPositive。这两件事放在一起,描述的是一套跟「替代艺术家」无关的策略:买下那条流程,让固定数量的艺术家能覆盖更多镜头。
Mousavi 反复回到一句话,听起来像采购需求:「我们要确保它不是一个黑箱。」摄影指导和美术指导必须能够塑造结果。如果做不到,这个工具就不会被用在项目上,demo 再好看也没用。
这才是当下 AI 视频真正的分界线。不是开源对闭源,不是 4K 对 1080p。而是:输出能不能被一个带着明确意图的人操纵,以及明天导演改主意的时候,能不能再操纵一次。60% 很容易。最后那 40% 才是工作。
相关文章
五大出版社悄悄用AI做封面,读者已经开始认出来了
《连线》报道称,美国五大出版社中至少三家在未披露的情况下用AI生成封面与文案。官方回应与员工说法相互矛盾,而名字印在封面上的作者,往往是最后一个知道的人。
Character.AI 申请破产,迪士尼用 2000 万美元给专利兜底
Character.AI 申请破产,迪士尼以 2000 万美元充当马前卒,买的只是部分资产和专利许可。一个 1.5 亿美元 A 轮的故事,最后落在专利和每月八九百万美元的亏损上。
XERJ:一个会坦白自己数字灌水的编码代理搜索引擎
XERJ 用本地索引和 tree-sitter 符号帮编码代理少读文件:实测比 grep 省 2.7 倍 token,而不是标题宣称的 40 倍,维护者自己把这层窗户纸捅破了。
别再让 AI 盯着屏幕点鼠标了:CLI-Anything 给每个软件配一条命令行
别教 agent 看屏幕点鼠标。CLI-Anything 用七阶段流水线为 GIMP、Blender、LibreOffice 生成带测试和文档的 CLI,让 agent 直接敲命令。