
Higgsfield 把一部 95 分钟 AI 电影的 40,000 条提示词全公开了
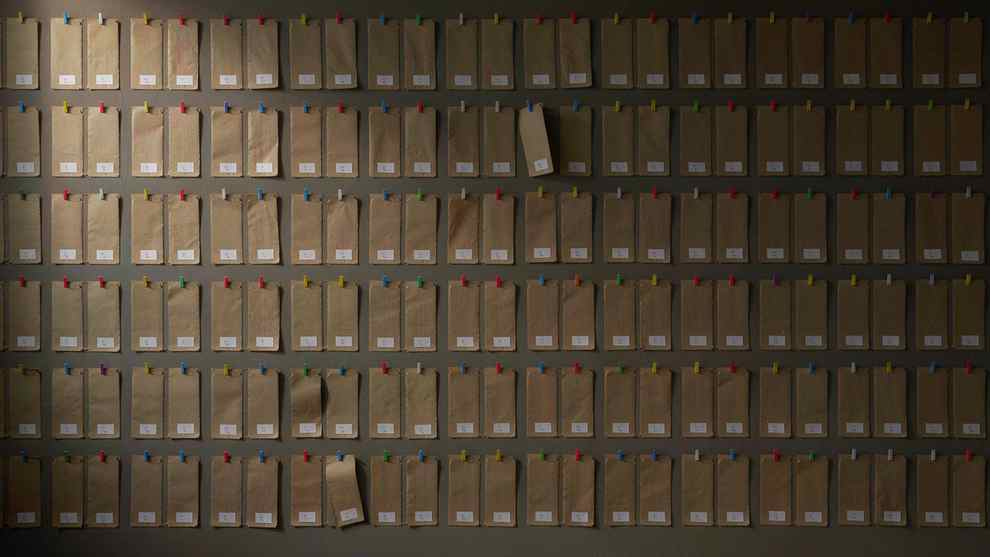
Higgsfield 公开了一部 95 分钟 AI 短片背后的提示词。全部。整个档案大约 40,000 条提示词,分在 108 个按场景排列的文件夹里,而这些提示词背后是 115,446 条生成记录。
把这两个数字放在一起看,才是真正的故事。四万条提示词是个很大的库。十一万五千次生成,是走到那一步的代价——平均下来每条提示词 2.9 次尝试,还是摊在一整部正片长度电影上的平均值。
这部电影叫 Hell Grind。表面上看,这次发布是一家卖视频生成的公司做的营销动作。往深了说,它是 AI 视频圈至今公开过的最有用的一份制作文档,而且它有用的原因,跟大多数人以为的不一样。
文件夹里到底装了什么
它的结构是按场景分的,不是按提示词类型分的。这件事比听上去重要。我见过的提示词库基本都按风格分类——“电影感打光”“动漫”“产品图”——那是编字典的排法。按场景排,才是排分镜脚本的排法。
打开一个场景文件夹,里面的提示词是按使用顺序排的,所以你能看到一条镜头是怎么被搭出来的:第一次尝试、第一次修正、第二次修正、最后进片的那条。失败的还留在里面。没人清理过。
大约 4,561 条提示词是中文,其余是英文。如果你用这两种语言中的任何一种写提示词,这个比例就有意义,因为同一个镜头存在两种写法,你可以直接对比。
为什么真正教你东西的是 115,446 这个数字
四万句话谁都能写。信息在比例里。
如果你只看过成片,你会以为一个靠谱的团队一两条就能出一条镜头。档案说平均接近三次,而平均数会盖住分布:有些镜头一次就过,有些明显磨了十几次,文件夹才往下走。
就这一个事实,就能重新校准你的预算。一部 95 分钟的电影要大约 115,000 次生成,那一条 3 分钟的宣发片大概要 3,600 次,一条 30 秒的社媒切片要几百次。不管你的积分预算多少,它大概只有实际所需的三分之一。
它也解释了为什么这类片子要几个月而不是几天。不是因为渲染慢,而是因为循环是:生成、看、判断、改写、再生成。瓶颈是判断,而判断没法并行。
怎么用这样的库,而不是照抄它
最明显也最错的做法是从头读到尾。你什么也学不到,还搭进去一个下午。
对的做法是把它当成一张按叙事功能索引的查找表。挑你自己项目里卡住的那场戏——角色进门、一个揭晓、两个地点之间的转场——然后去 Hell Grind 里找对应节拍,只读那一个文件夹。
你要找的不是措辞,是结构:要素是按什么顺序写的,哪些细节每一次都重复了(通常就是模型老是丢的那些),以及团队在哪里停止描述、开始约束。能扛过反复迭代的提示词往往会收敛成一种模式,而模式才是能迁移的部分。
双语那部分是白送的第二课。拿一条镜头,读它的英文提示词和中文提示词,看翻译里加了什么、丢了什么。通常中文版带更多氛围,英文版带更多机位和灯光,因为每种语言说某些事的方式更省力。
另一个项目,才是电影人该读两遍的
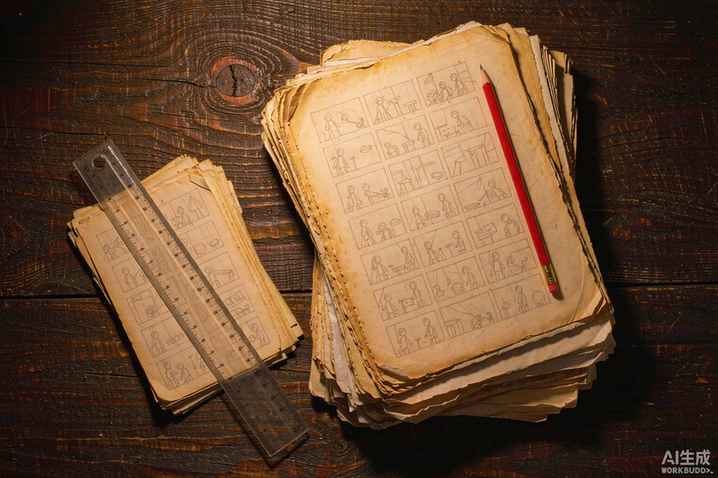
除了 Hell Grind,Higgsfield 还开源了 Passport Rush,一部用混合流程做出来的短片:先手绘 2D 分镜,再在 Blender 里做 3D 预演,最后才做 AI 动画。
这个顺序本身就是全部论点。先分镜,再在 3D 里摆位,最后才生成。这跟大多数人用这些工具的顺序正好相反——先写提示词,出事再修——也正是成片在剪辑点之间站得住的原因:机位和空间关系在任何一个模型跑起来之前,就已经由人定好了。
对做客户项目的人来说,混合路线还顺带解决了过稿问题。你可以在花掉一个积分之前,把分镜和 Blender 灰模布局给客户看。这个阶段收意见不花钱。四十次生成之后再收意见,要花一个周末。
这对“写提示词”这份工作意味着什么
有一种解读是:对现在靠写提示词吃饭的人是坏消息。理由大概是,工作档案都公开了,这门手艺就被商品化了。
这说法反了。被商品化的是词汇——那种能让模型生成黄昏雾街的具体说法。不能被商品化的是判断:这部电影需要哪个镜头,这个镜头该停多久。
实际上价值往上走了一层。提示词不再是交付物,而是你已经做过的某个决定的记录。这也是文件夹按场景分类的原因:场景才是作者的创作单位,提示词只是你留给渲染器的一张便条。
电影学院的学生本来就是这么学的。你不会只读一位导演的分镜表来研究他;你先看电影,再读分镜表,然后再看一遍。这个档案就是中间那一步,只是规模很大,服务于一种还没有电影学院的媒介。
商业逻辑也不难懂
Higgsfield 运营着一个社区,创作者在上面发布 “Open Projects”:成片、创作简述、文件夹结构、用到的模型,以及可选的每一条提示词。项目拿到 30 个赞、内部有 30 次生成,就会进人工审核并认证,创作者因此拿到评分和申请资助的资格。
所以公开提示词不是做慈善,是个飞轮:提示词让项目可复现,可复现的项目会被 remix,remix 带来使用量,而使用量正是生成公司卖的东西。这 40,000 条提示词同时是教学资源和获客渠道。
这并不让它们变得没用,只是意味着你该预期看到更多。竞争压力现在指向透明,因为公开提示词档案的工作室显得有底气,藏起来的看起来像是有事瞒着。
该说清楚的保留意见
Hell Grind 里的一切都服务同一种审美。暗、重质感、重特效。如果你在做明亮的产品片或者儿童动画,这个档案里的大部分都是错误参考,你会对着一种你不想要的风格做模式匹配。
把它当成一份流程的实操样本,而不是风格指南。要学的不是“就这样写提示词”,而是“每条镜头按三次尝试做预算,生成之前先定机位,把失败的留在文件夹里,这样你能看见自己试过什么”。
最后这个习惯几乎没人有,而且不花钱。
相关文章
5B 的 MOSS-Image 把海报上的中文写对了,代价是它不会改图
开源权重新高的长文本渲染分数、能按坐标摆版式的 JSON Layout,以及一个绕不过去的短板:它是纯文生图,接不了参考图,也改不了图。
Cloudflare 开源了自用的审计器:值钱的是它会反驳
六个阶段、三种结论,还有一条最要紧的规则:检查 finding 的 agent 永远不是发现它的那个;Cloudflare 也承认单次运行大约只找到一半。
LLM 智能体拼出一家交易公司:117,000 星,先读免责声明
分析师、多头、空头、交易员、风控、组合经理——组织架构就是系统架构,而 README 里那句关于非确定性的提醒,才是全文最重要的一行。
225,000 颗 star 只为一份 markdown:Karpathy 的抱怨变成四条规则
没有代码,没有构建,没有 benchmark:四原则写进一份 CLAUDE.md,比今年大多数讲能力的发布都更受关注,而这个落差本身就是新闻。