
2.6 億參數圖像模型靠迴圈相同區塊,擊敗大 6.5 倍的對手
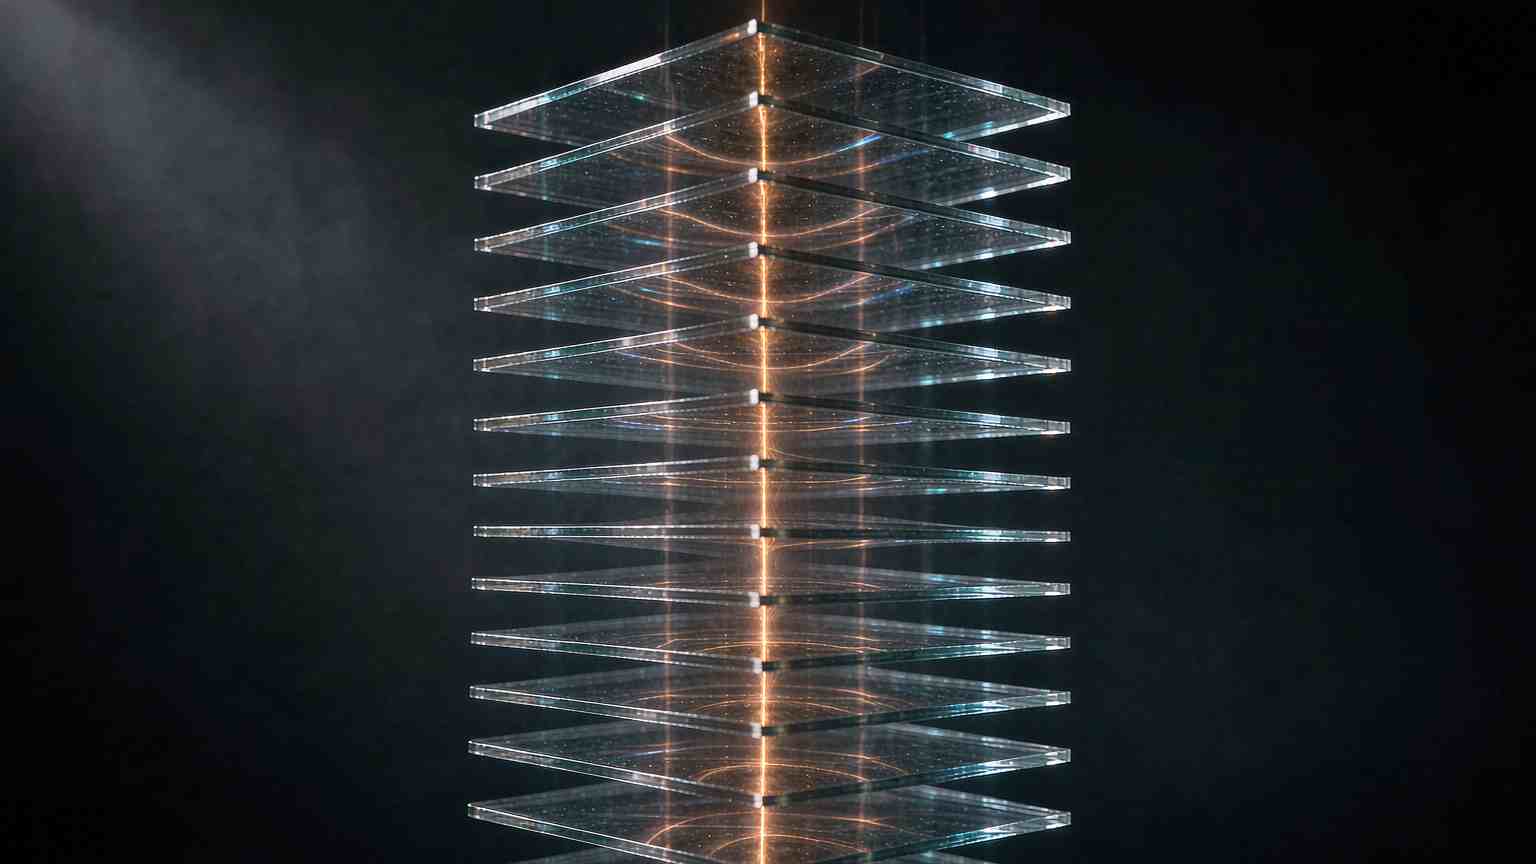
一篇新論文提出了一種擴展文字生成圖像模型的不同方法,而其結果是那種會讓人多看兩眼的數字。據報導,一個 2.6 億參數的模型在每個去噪步驟中反覆運行一組共享的 Transformer 區塊,而不是增加新參數,擊敗了規模大 6.5 倍的對手,同時使用的運算量約少 4.9 倍。這項技術稱為迴圈擴散 Transformer(Looped Diffusion Transformer),其背後的想法在機器學習其他領域早已為人所熟悉。
其原理是跨深度的權重共享。標準圖像模型透過堆疊更多區塊來變強,而每個區塊都帶有自己的參數。迴圈模型則在單一去噪步驟內反覆運行一組較小的區塊,讓同一組權重在做更多工作之後才完成圖像。運算量會隨迴圈次數增加,但參數數量保持不變,這改變了任何思考模型將在哪裡運行的人所面對的算式。
為何參數位於何處很重要
參數數量和運算量通常會一起被討論,但它們限制的是不同的事情。參數決定模型佔用多少記憶體,且往往決定它是否能裝進個人實際擁有的硬體。運算量則決定生成需要多久,以及提供服務的成本。
以迴圈次數換取參數的設計,瞄準的是第一個限制,但沒有忽略第二個。據報導的 4.9 倍運算節省顯示,在這個基準上這筆交易是有利的,儘管論文中的結果不等於已發布檢查點的結果,而且迴圈式架構的訓練穩定性在先前的作品中一直是反覆出現的疑慮。
開放圖像競賽現在比的是佔用空間
時機之所以相關,是因為開放圖像社群過去一年一直在不同的軸線上競爭。記憶體佔用成為明確目標,模型宣傳重點在於需要多少 VRAM,以及能減少取樣步驟數量的蒸餾技術。減少步驟的方法和減少參數的方法,從同一條流程的兩端攻擊這個問題。迴圈擴散 Transformer 則位於參數這一端。
史丹佛 NLP 的一項相關成果也朝類似方向前進。一種稱為 UniEvo-VL 的方法使用同策略自我蒸餾,讓單一模型同時扮演教師和學生,在沒有外部教師模型的情況下,將基於 Qwen 的圖像模型 GenEval 分數從 0.747 提升到 0.808。貫穿其中的主線相同:從既有模型中榨出更多能力,而不是訓練一個更大的模型。
這不只是研究品味。開放權重文字生成圖像排行榜的頂端,是一個規模適中、彼此接近的緊密叢集。Qwen-Image-2.1 以約 1,036 Elo 領先,其生成元件有 70 億參數,排在 FLUX.2 dev 和 HunyuanImage 3.0 Instruct 之前。最好的開放模型仍大幅落後 OpenAI 的 GPT Image 2.5 Sunburst,後者接近 1,197。如果以規模而言前沿遙不可及,那麼效率技巧就成為較小實驗室留在對話中的方式。
誠實的注意事項
第一,頭條比較只是單一基準。一個大 6.5 倍的對手在一項評估中輸給迴圈模型,並不代表這項技術在所有地方都勝出,而且圖像品質對提示詞和取樣器選擇的敏感程度眾所周知。第二,這個領域中自我回報的勝利,往往在獨立測試下縮水,尤其是當推論不是在相同硬體和設定上運行時。第三,迴圈以訓練簡單性換取推論效率,而當迴圈次數設定錯誤時的失敗模式,無法從發布摘要中明顯看出。
這些都不會推翻方向。對實際創作者來說,有趣的問題不是 2.6 億參數模型是否在表格中擊敗大 6.5 倍的對手。而是這個設計是否會出現在可下載的檢查點中,能在消費級 GPU 上運行,而不需要四小時的設定。效率技術的模式一向如此:它們從論文開始,被社群微調吸收,然後在幾個月內成為一種理所當然的期待,而不是一項功能。
值得關注的重點
留意迴圈式或權重共享設計是否出現在發布的權重中,而不只是在論文裡,以及運算節省能否在更高解析度下維持,因為在那裡注意力成本會主導。關注下一輪開放發布後的排行榜,因為一項降低參數門檻的技術,往往會表現為好幾個新模型同時落在同一個效率區間。
這批研究更廣泛的教訓是,圖像生成中的規模化討論已經成熟。增加參數仍然有效。但更活躍的工作在於讓既有模型以更少資源做更多事,而這種進展比資料中心更快抵達筆電。
為何迴圈是個老點子卻有了新動能
跨深度的權重共享並不新鮮。它出現在多年前的遞迴網路中,也出現在好幾個語言模型裡,這些模型重複使用一組層,而不是堆疊獨特的層。如今它對擴散模型之所以有趣,在於生成過程的結構。生成一張圖像會經過許多去噪步驟,而每個步驟本來就會運行整個網路。在一個步驟內迴圈增加了第二條重複軸線,這意味著運算倍率和品質增益可以某種程度上獨立調整。
取捨是真實的。重複使用權重會讓訓練更困難,因為每次迴圈的梯度都必須流經同一組參數,而迴圈過於積極的模型可能會失去精細細節。據報導的結果使用了一個論文有餘裕去調整的特定迴圈次數;已發布的檢查點則必須在廣泛使用者提出的各種提示詞下都能運作,這是更嚴格的測試。
還有一個實際原因,會讓社群比基準所顯示的更在意這件事。幾乎所有流通中的開放圖像模型,都有一部分是根據它需要多少 VRAM 來評判,因為運行它們的人用的是一、兩張消費級 GPU,而不是叢集。一種降低參數門檻、又不會對品質造成等比例打擊的設計,直接切中那群使用者,而那群使用者如今已大到足以形塑哪些技術會被採用。
效率軍備競賽有兩條戰線
把被綁在一起稱為「效率」的兩個槓桿分開來看會有幫助。步驟蒸餾減少去噪遍數,主要降低生成時間和每張圖像的成本。參數縮減——也就是迴圈式設計所瞄準的——主要降低記憶體和下載大小。一個模型可以又快又大,也可以又慢又小,而最佳選擇取決於機器。
過去一年的開放圖像發布強力推動了第一個槓桿,四步和兩步變體成為任何要互動式運行的模型的常態。第二個槓桿進展較慢,這就是為什麼一項關於參數效率的成果會格外突出。如果它能站得住腳,預期會看到它與蒸餾取樣器結合,產生既小到能裝下、又快到能使用的模型,而這大致就是裝置端圖像生成故事一直以來的走向。
這些都不是一篇論文能保證的。但方向很清楚,而對於任何曾排隊等待生成單張圖像的人來說,回報是具體可感的。
相關文章
AI 影片價格戰:Luma 將 Seedance 費率調降最多 73%,Runway 開始販售對手模型
如今各引擎的差距已經夠小,帳單比排行榜更能指引方向。
兩款語音模型刷新標竿:首段音訊只要 50 毫秒,還有能在筆電 CPU 上運行的 99M 模型
品質趨於一致之後,競爭轉向了模型在哪裡運行、啟動多快,以及每次呼叫的成本。
Moonshot 的 Kimi K2.6 可同時運行上千個代理,並在十小時內打造出一套編譯器
一千個代理若每個都需要監督,被放大的就是監督工作,而不是產能。
Oracle 把代理程式編排搬進 ERP,治理的盤算就此改變
代理程式的「能力」已不再是頭條。現在的頭條是:公司能不能在事後證明它的代理程式究竟做了什麼。