
Alibaba disponibiliza em código aberto um modelo que divide uma imagem plana em camadas editáveis
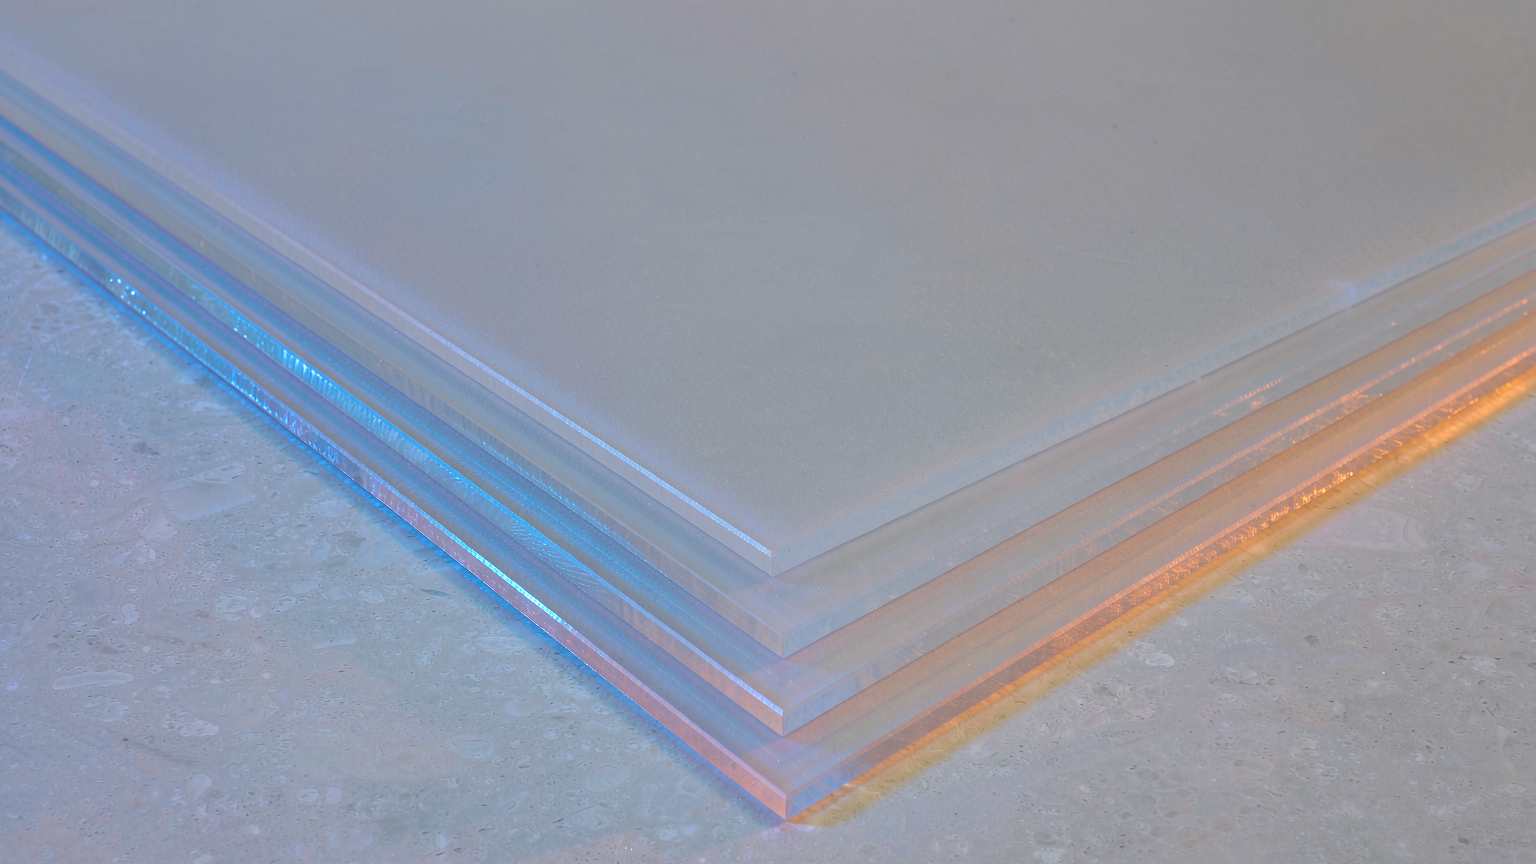
A equipe Qwen, da Alibaba, publicou o Qwen-Image-Layered no ModelScope e no Hugging Face no início de outubro, com uma licença que permite uso comercial. O anúncio chinês de 2 de outubro descreveu-o como o primeiro modelo de imagem com compreensão e edição de camadas nativas, no estilo Photoshop. Vale a pena destrinchar essa afirmação, porque o mecanismo por trás dela não é o que a maioria dos editores de imagem vem buscando.
A forma padrão de editar uma imagem gerada é selecionar uma região e regenerá-la por dentro. O inpainting funciona assim. O FLUX 3 Image, lançado no dia anterior, também funciona assim, com caixas delimitadoras que definem exatamente quais pixels o modelo pode tocar. A abordagem tem uma fraqueza conhecida: o modelo não faz ideia do que é uma camada. Ele vê uma região retangular e um prompt, e preenche o buraco.
O Qwen-Image-Layered parte de uma representação diferente. Ele decompõe uma imagem finalizada em um conjunto de camadas RGBA, cada uma em resolução total e cada uma com sua própria transparência. Um objeto vira uma camada, um trecho de texto vira outra, o fundo vira uma terceira. Você pode mover uma camada, recolorizá-la ou substituí-la e depois recompor a pilha. O objetivo de treinamento é o que torna isso mensurável: o modelo aprende a produzir camadas cuja recomposição reproduz a imagem de entrada, de modo que a qualidade da decomposição tem uma pontuação direta.
Por que este é um problema diferente da segmentação
Segmentar uma imagem em objetos é uma tarefa antiga, e os modelos já são bons nisso há algum tempo. A decomposição em camadas exige algo mais específico. A saída precisa ser utilizável como uma primitiva de edição, o que significa que cada camada precisa de bordas alfa limpas, ordem de empilhamento correta e nenhuma contagem dupla de pixels que aparecem em duas camadas ao mesmo tempo.
Ambos esses modos de falha são comuns. Um recorte de uma pessoa em pé diante de uma parede, em uma segmentação ingênua, deixará um fantasma da pessoa atrás quando a camada for removida. A camada da parede precisa ter aprendido que a pessoa a oclui e precisa reconstruir como a parede era atrás da pessoa. Isso é um problema de geração, não de rotulagem, e é por isso que a representação RGBA importa. Cada camada carrega seu próprio canal alfa, então o modelo precisa decidir, pixel a pixel, qual camada é dona do quê.
O relatório chinês credita duas peças de arquitetura por isso: um codificador RGBA-VAE criado especificamente para essa finalidade e codificação posicional 3D em nível de camada. A segunda é a parte interessante. Se as camadas são empilhadas em profundidade, o modelo precisa de alguma noção de onde cada uma fica nessa pilha, que é o que a codificação posicional fornece.
A alegação de "zero drift"
A promessa é que as edições causam quase nenhum drift: altere uma camada e todo o resto permanece no lugar.
O drift é a falha que todo mundo que já editou uma imagem gerada conhece. Você pede uma troca de fundo, e o modelo devolve um rosto um pouco diferente, ou uma camisa em outro tom, ou uma sombra que se moveu. Toda edição baseada em difusão carrega um pouco disso, porque o modelo regenera mais do que você pediu. O novo recurso Prompt to Edit do Lightroom, da Adobe, tem exatamente esse problema, e é por isso que fotógrafos desconfiam dele.
Um modelo de camadas contorna a questão estruturalmente. Se o objeto que você não está editando existe como uma camada RGBA separada, e a edição toca apenas uma camada diferente, a camada intocada é copiada em vez de regenerada. O drift se torna um bug no compositor, e não uma propriedade do modelo.
Essa é uma garantia mais limpa do que qualquer abordagem de inpainting pode oferecer, e é por isso que a escolha arquitetural é a notícia aqui, e não os números de benchmark.
O que isso muda para o trabalho real
Três fluxos de trabalho ficam mais curtos.
Reutilização de ativos existentes. Uma foto de produto embutida em um banner pode ser extraída e reutilizada sem que alguém trace um caminho de recorte. A camada já está lá, com alfa.
Saída transparente. Um modelo que emite camadas RGBA por padrão pode produzir PNGs transparentes como efeito colateral de sua operação normal. Isso elimina uma etapa que atualmente exige um modelo de segmentação ou mascaramento manual.
Variação em lote. Se a imagem mestre é uma pilha de camadas, uma equipe pode regenerar variações trocando uma camada e recompondo. O resto da imagem fica intocado, o que importa quando as diretrizes de marca fixam tudo, exceto o produto.
Um quarto é menos óbvio. Camadas são dados estruturados. Uma pilha de componentes RGBA nomeados alimenta um editor ou um pipeline automatizado de forma muito mais limpa do que um bitmap plano, o que torna o modelo útil como componente, e não como destino.
Onde estão os limites
O modelo decompõe uma imagem. Ele não sabe como as camadas deveriam se chamar, e não infere intenção. Peça para ele dividir a fotografia de uma mesa bagunçada e o resultado pode separar bem os objetos e mal a iluminação. Materiais semitransparentes são o caso difícil, já que um copo de água pode, a rigor, pertencer a várias camadas ao mesmo tempo.
A ordenação de profundidade também permanece ambígua para reflexos e sombras. Uma sombra projetada em uma parede é uma propriedade de um objeto, mas ela vive na camada de fundo, e decidir de que lado dessa linha colocá-la é um julgamento que o modelo precisa fazer sem que lhe digam.
Nada disso torna o lançamento menos significativo. Torna-o uma fundação, e não uma ferramenta pronta.
Por que o formato de camadas viaja melhor do que um inpainter melhor
Nos últimos dois anos, a corrida dos modelos de imagem foi disputada no mesmo percurso. Cada geração produziu inpainting mais nítido, melhor aderência ao prompt e menos artefatos óbvios.
Esse percurso tem limites, e eles são estruturais. Não importa quão bom o inpainter fique, o modelo de interação permanece o mesmo: o usuário define uma região, o modelo a preenche e o usuário julga o resultado. A qualidade melhora, mas o fluxo de trabalho não muda. A evidência é que a mesma reclamação continua recorrente entre gerações de modelos: a de que uma edição local produz mudanças em outro lugar.
As camadas atacam o fluxo de trabalho em vez da métrica de qualidade. Quando uma imagem é uma pilha, a unidade de trabalho passa a ser a camada, e não a seleção, e o usuário manipula componentes diretamente. É assim que designers trabalham em ferramentas dedicadas há trinta anos, e a razão pela qual os modelos de imagem não faziam isso era que a representação não estava disponível.
Construir essa representação é caro. Um modelo precisa aprender oclusão, ordenação de profundidade e alfa a partir de dados que, em sua maioria, não contêm decomposições em camadas, e é por isso que o objetivo de treinamento, a reconstrução da entrada a partir da pilha prevista, é a parte estrutural do design.
Se a abordagem funcionar, as consequências vão além dos próprios produtos da Alibaba. Uma ferramenta de composição que aceita uma pilha de camadas pode ser conectada a um pipeline que antes precisava de um humano para recortar máscaras. Uma biblioteca de banco de imagens que entrega decomposições se torna mais valiosa do que uma que entrega JPEGs planos. O modelo é a primeira peça dessa cadeia, e o ecossistema ainda não tem o resto dela.
O cenário competitivo
A decomposição em camadas não é exclusiva da Alibaba. O Ming-Image, do Ant Group, adota uma posição relacionada, gerando designs como composições em camadas em vez de imagens planas. A Stability e outras empresas lançaram modelos de segmentação que se aproximam de partes do fluxo de trabalho. O que difere é o compromisso com camadas RGBA como formato de saída nativo e a decisão de liberar pesos que qualquer pessoa pode executar.
Essa última escolha importa para a velocidade com que a ideia se espalha. O mercado de ferramentas de imagem passou dois anos convergindo para a interação de "selecionar uma região, descrever uma mudança", e os resultados estagnaram em qualidade pela simples razão de que a representação subjacente não mudou. Entregar ao ecossistema uma pilha editável em vez de um bitmap é o tipo de mudança que aparece nos produtos de outras pessoas antes de aparecer em uma tabela de benchmark.
O que observar é se as ferramentas de composição começarão a aceitar pilhas de camadas como formato de entrada, e se os editores passarão a tratar a decomposição como o primeiro passo de um projeto, em vez de uma operação de reparo. A pontuação de benchmark é uma questão secundária.
Artigos relacionados
A Salesforce deu aos seus agentes um runtime que funciona por semanas
A lista de agentes é a parte menos interessante. O runtime por baixo dela muda para que serve um agente.
Cohere impõe um teto rígido ao que um agente corporativo pode gastar
Um agente que roda sem supervisão é um agente que pode acumular uma conta sem supervisão. O North 2 torna o orçamento parte do produto.
A Adobe colocou a edição generativa dentro do Lightroom, e os fotógrafos têm razão em ficar nervosos
Uma ferramenta que fica entre os controles deslizantes incentiva a crença de que é um ajuste rotineiro. Ela reescreve a fotografia.
JetBrains coloca um orquestrador de agentes dentro de cada IDE que lança
A JetBrains não está competindo pela qualidade do modelo. Está competindo pela camada onde os agentes são iniciados e revisados.