
アリババ、大規模モデルを自社シリコンに詰め込む:真武 V900は3倍高速化、Qwen 4は訓練中
9月下旬の杭州雲栖大会で、アリババは三つのことを同じテーブルに並べた。新しいチップ、訓練中のモデルの一版、そして2032年までのデータセンターの請求書だ。例年、この種のカンファレンスではモデルが主役になることが多かったが、今年繰り返し言及されたのはシリコンだった。
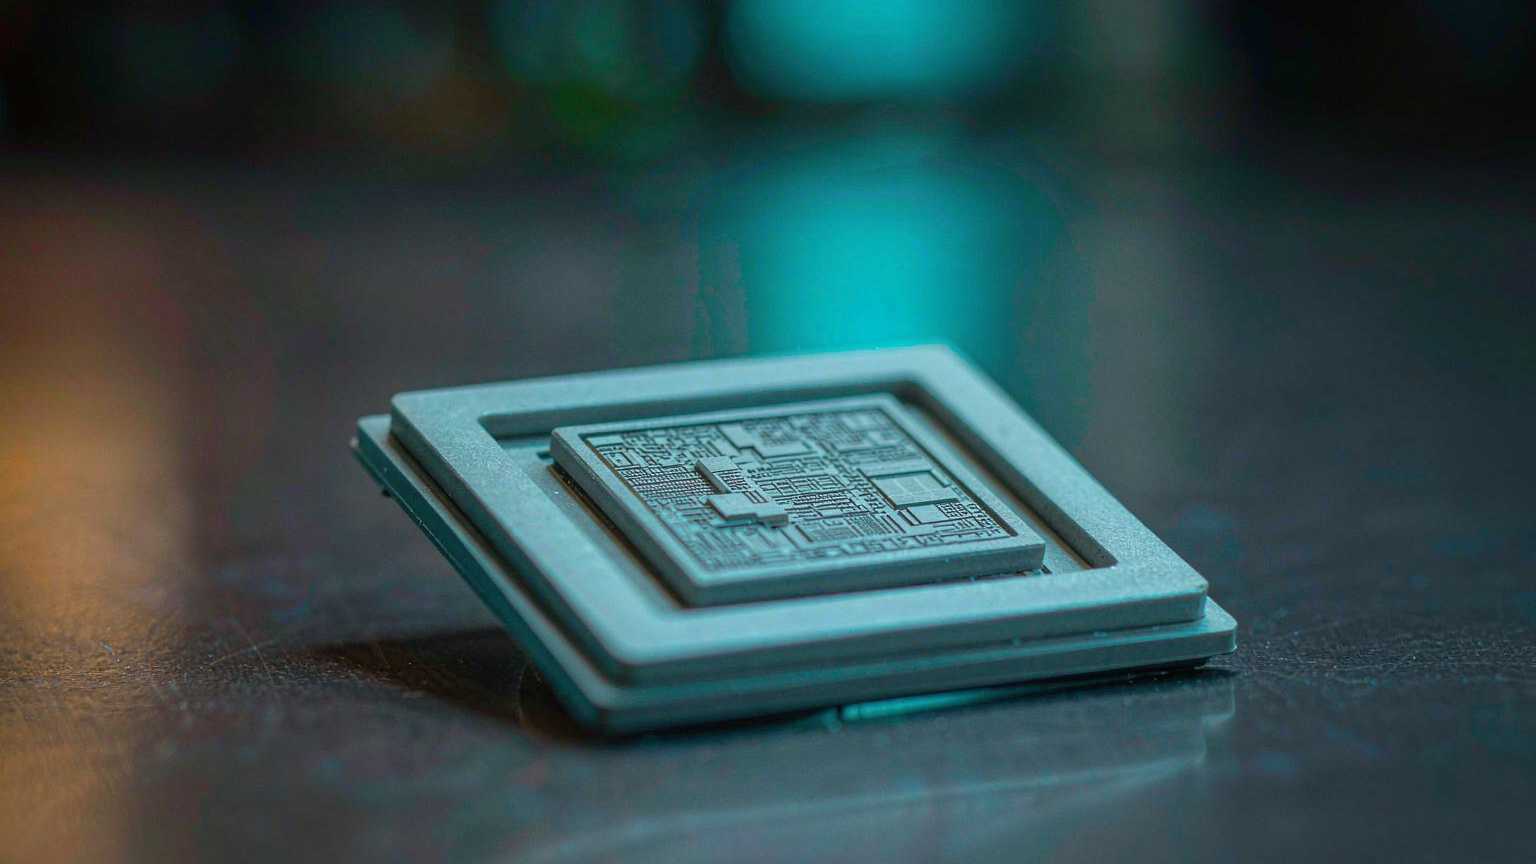
アリババ傘下の平頭哥(T-Head)は、訓練・推論一体型のAIチップ「真武 V900」を発表した。公式説明によれば、その演算性能は真武 M890の3倍で、216GBのVRAM、1200GB/sのチップ間相互接続帯域を備え、FP8とFP4の2種類の低精度フォーマットをネイティブサポートする。真武 M890は今年5月に発表されたばかりで、その間隔はわずか4カ月しかない。V900は2027年第1四半期まで量産・販売されないため、今ステージに置かれているのは依然として仕様表であり、注文できる在庫ではない。
本当に見るべきなのは、その背後にあるネットワーキング方式だ。平頭哥はV900向けに自社開発のインターコネクトチップ「ICNSwitch」を用意し、メモリセマンティクスとメモリの統一アドレッシングを実現した。数千個のV900が一つの「スーパーチップ」のように協調動作できると謳っている。同時発表されたスーパーノードサーバーには、V900に加えて自社製のスマートNICとSSDコントローラーチップも組み込まれ、計算・ストレージ・ネットワークをすべて自社で握ろうとしている。アリババの開示によれば、単一クラスタは50万枚規模まで拡張できる。
アリババの手元にはすでに一定の実運用ワークロードがある。真武 M890ベースのスーパーノードは以前、Qwen3.8やKimi K3のような2兆パラメータ超のモデルを走らせた実績があり、真武シリーズのチップは累計650社以上の企業顧客にサービスを提供し、自動運転、金融、エネルギー、製造などの業界をカバーしている。これらの数字は、アリババが次世代クラスタの規模を50万枚と公言できる理由を説明している。
モデル側の動きはより直接的だ。アリババはQwen 4がすでに訓練中であることを確認し、Qwen 4.5とQwen 5の目標パラメータ規模は5兆から10兆の間にあるとした。参考として、現在アリババで最強のQwen3.8-Maxは2.4兆パラメータだ。パラメータの拡大とクラスタの拡大は同じ事柄の表裏である。十分なカードがなければ、兆級モデルの訓練期間は意味を失うほど長期化してしまう。
アリババクラウドは、2032年までに世界のデータセンター規模を20GW超にするというインフラ目標を掲げ、同時に今後1年でトルコ、フィンランド、オランダの3つの新リージョンを開設し、マレーシア、ドイツ、アラブ首長国連邦、フランスなどで拡張する計画だ。チップ、モデル、クラウドを同じ戦略の中で語ることは、今回のカンファレンスで最も明確な主軸だった。
数字は立派だが、ベンチマークは自社比だ
このロードマップを評価する際には、二つの点に注意する必要がある。
第一に、3倍の向上はV900を自社のM890と比較したものであり、NVIDIAのBlackwellと比較したものでも、他社のアクセラレータカードと比較したものでもない。VRAM容量と相互接続帯域は、実際の訓練スループット、推論遅延、トークンあたりコストへ直接換算できるものではない。アリババは独立した第三者テストによるスコアも公表していない。
第二に、ソフトウェアエコシステムだ。世界の主流の大規模モデル訓練コードは長らくCUDAを中心に書かれており、ドライバーのライブラリ、コンテナ、オーケストレーションツールは長年の蓄積の上に成り立っている。NVIDIAプラットフォーム上で動くワークロード一式を新しいチップへ移行するコストは、しばしばハードウェアの仕様には現れず、エンジニアがコードを書き換え、性能を調整する数週間に現れる。アリババは今回、V900と既存のNVIDIAツールチェーン間の移行難易度を説明しておらず、価格、利用可能なインスタンスタイプ、リージョンサポートも公表していない。
これはアリババだけの問題ではない。先端プロセスの生産能力、歩留まり、ワットあたり性能は、中国国内の自社開発チップが直面する現実的な制約である。真武 V900の意義は、むしろ「自分たちで作れるか」という問いを一歩前進させた点にあり、単一の指標で追いついたことではない。
なぜ今なのか
タイミングは詳しく見る価値がある。過去2年間、米国による中国への先端GPU輸出規制は継続的に厳しくなり、国内クラウド事業者は自社開発アクセラレータへの投資を加速せざるを得なかった。アリババ、ファーウェイに加え、燧原(Enflame)や天数智芯(Iluvatar CoreX)といったより小規模なプレイヤーも、同じ方向に力を注いでいる。同時期に、ファーウェイも次世代AIチップの発表ペースを前倒ししているとの報道があった。両社の対外的な説明はほぼ同じだ。規制でさらに妨げられる前に、まず中国市場でNVIDIAの座を置き換える、というものだ。
アリババ自身にとって、自社開発シリコンには二つの利点がある。一つは米国政策の変動へのエクスポージャーを減らし、計算資源の計画が輸出ルールに左右されないようにすること。もう一つは、歴史的にNVIDIAに奪われてきたチップ+クラウドの利益を自社内に留めることだ。
モデル発表だけを見ていると、この競争は依然として誰のパラメータが大きいか、誰のスコアが高いかの勝負に見える。しかしチップ、スーパーノード、クラウドリージョン、モデルのロードマップをまとめて見ると、競争の戦場はすでにシリコンとデータセンターの層へ移っている。モデルは看板であり、自社でカードを作り、ネットワークを自ら組み、電力を自給できるかどうかが、この建物をどこまで高く建てられるかを決める。
試練はこれから
今後12~18カ月で、三つのことが答えを出す。50万枚のスーパーノードという説が実際の顧客導入で検証に耐えられるか。Qwen 4.5とQwen 5が本当に10兆パラメータ近い規模まで到達できるか。そして20GWのデータセンター目標に対して、相応の資金調達と電力を確保できるか。
そのうちのどれか一つでも半分実現すれば、中国のAIハードウェアスタックがNVIDIAとの距離を縮めていることを示すのに十分だ。その縮小は、必ずしも特定の指標の同等性に現れるとは限らず、むしろ導入規模そのものに現れる可能性が高い。アリババはすでに杭州で言葉を発した。残りは量産ラインと電力メーターが答えることになる。
関連記事
13,000枚の社内スクリーンショットが公開GitHubに流出、攻撃者の関与はなし
デフォルトの挙動がフリート全体で繰り返されるとき、それはポリシーの帰結となる。
アマゾン、自社が使い続ける80億ドル分のNvidiaチップを投資家に保有させようと画策
航空会社は何十年も航空機をリースバックしてきた。今、同じ発想がGPUに適用されようとしている。
OpenAI、推論抽出キャンペーンをMoonshot AI関係者に追跡
モデルは、自らの隠された推論のための復号オラクルと化した。
初のAI映画祭は45万ドルを支払い、ストーリーについての教訓を残した
受賞作は、すでに存在していたアイデアに奉仕するためにツールを使っていた。