
Fei-Fei Lis Atlas verwandelt ein Foto in einen begehbaren Raum
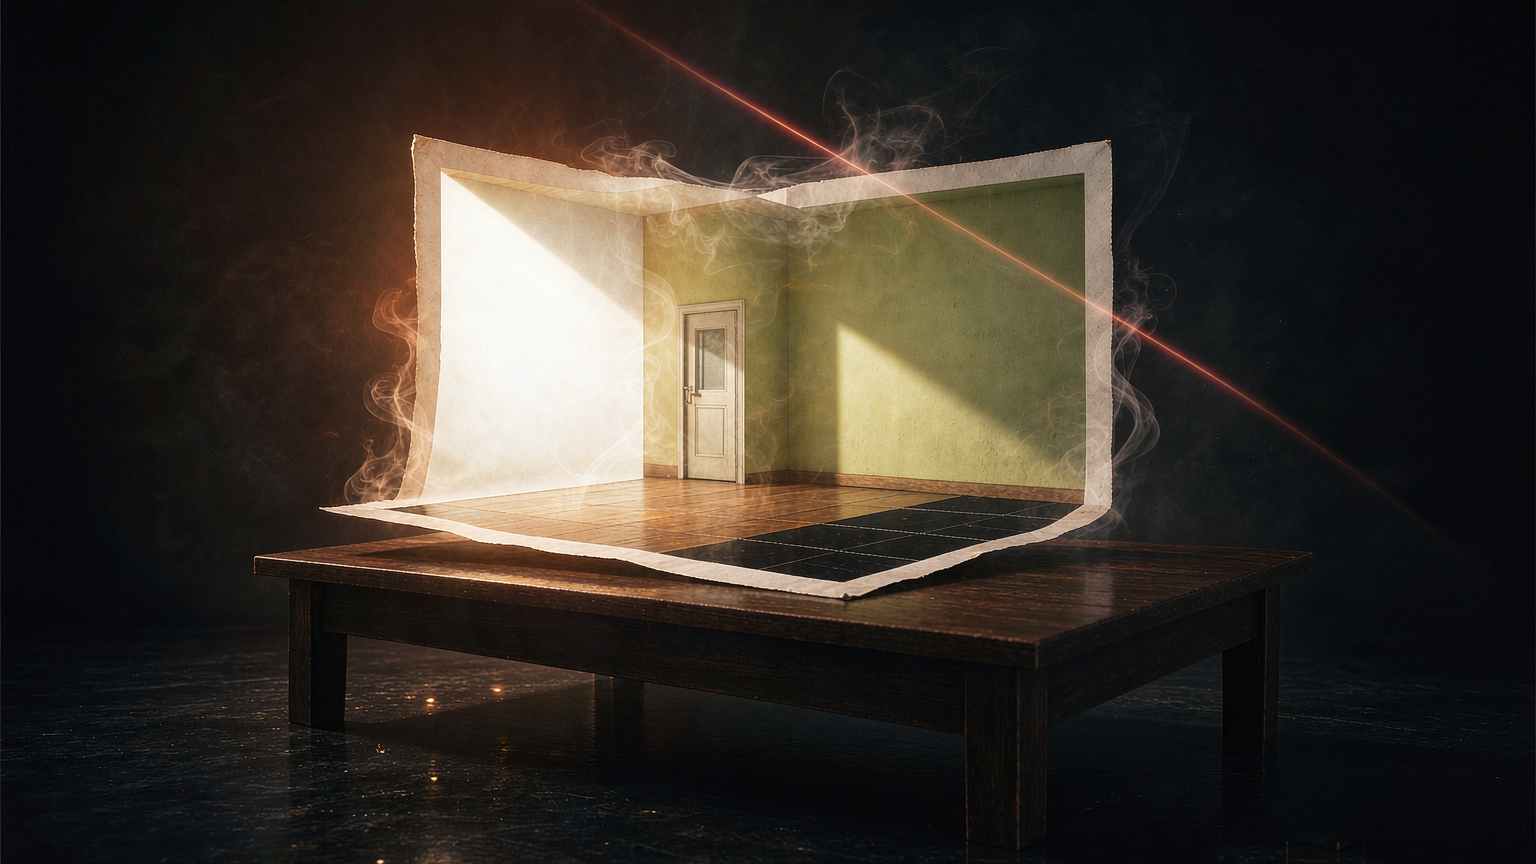
World Labs hat Atlas am 1. September in den Early Access gestellt. Das Unternehmen, das Fei-Fei Li mitgegründet hat, nennt es ein Omni-Weltmodell für räumliche Intelligenz, und die Demonstration besteht darin, dass ein paar gewöhnliche Handyfotos eines Raums hineingehen und eine interaktive 3D-Szene herauskommt. Man kann eine virtuelle Kamera überall darin bewegen. Man kann Tiefe daraus lesen. Man kann die Geometrie an einen Roboter übergeben und sie als Ort zum Üben nutzen.
Li argumentiert seit Jahren, dass die nächste Grenze der KI nicht die Sprache, sondern die physische Welt ist. Ihr Begriff dafür ist räumliche Intelligenz, und die Behauptung lautet, dass einem Modell, das nur mit Text und flachen Bildern trainiert wurde, etwas Grundlegendes fehlt. Sprachmodelle beschreiben eine Welt, die sie nicht sehen können. Atlas ist der bisher klarste Versuch, eines zu bauen, das es kann.
Was Atlas leistet
World Labs beschreibt Atlas als multimodalen autoregressiven Diffusions-Transformer, eine einzige Architektur, die Text, Bilder, Video und 3D-Daten innerhalb eines räumlichen Rahmens aufnimmt und über dieselben Modalitäten hinweg generiert. Die Ausgaben sind breiter gefasst als bei einem Videogenerator: kameragesteuerte Bilder und Videos bis zu 1440p für Clips von etwa einer Minute, dazu neue Blickwinkel, Tiefenkarten, Punktwolken und 3D-Gaussian-Splats.
Die volumetrische Ausgabe ist das, was dies von einem Text-zu-Video-Modell unterscheidet. Ein Videogenerator sagt den nächsten Frame voraus. Er weiß nicht unbedingt, wo etwas im Raum liegt oder wie eine Szene aus einem Blickwinkel aussieht, den die Kamera nie eingenommen hat. Atlas führt eine interne 3D-Repräsentation mit sich, sodass eine Umgebung zusammenhält, während sich ein Betrachter durch sie bewegt. Der Unterschied zwischen einem plausiblen Clip und einem navigierbaren Raum ist genau der Grund, warum man von einem Weltmodell spricht.
Aus einer spärlichen Eingabe, in einigen Demonstrationen nur ein paar Frames von Handyaufnahmen, rekonstruiert das Modell eine Szene gut genug, um eine virtuelle Kamera darin zu platzieren. World Labs berichtet von einem Rekonstruktionsfehler bei dünner Ansicht von 25,3, niedriger als der des besten spezialisierten Modells mit 28,7. In beauftragten Blindtests bevorzugten menschliche Bewerter die Befolgung einer angeforderten Kamerabewegung durch Atlas gegenüber MiniMax H3 in 75 Prozent der Fälle, gegenüber Gemini Omni Flash in 81 Prozent und gegenüber Seedance 2.5 in 94 Prozent.
Das sind die eigenen Zahlen des Unternehmens aus selbst durchgeführten Evaluationen, was man klar sagen sollte. Atlas befindet sich im Early Access, daher kann noch niemand außerhalb der Partnergruppe sie reproduzieren.
Real-to-Sim und warum Roboter sich dafür interessieren
Die offensichtlichen kommerziellen Anwendungen sind visuelle Effekte, Spiele und virtuelle Produktion. Ein Filmemacher kann eine Einstellung nach dem Dreh inszenieren. Der Rahmen, auf den World Labs sich stützt, ist jedoch die Robotik.
Der Workflow heißt Real-to-Sim. Man nimmt Video von einem realen Raum auf, und Atlas wandelt es in eine 3D-Simulation um, in der ein Roboter trainiert oder getestet werden kann, ohne die Kosten und Risiken des Betriebs des echten Gegenstücks. Ein Robotikteam, das tausend Varianten eines Lagerhausgangs möchte, kann den Gang einmal scannen und die Varianten generieren, statt jede einzelne zu filmen.
Das ist ein eng umrissener, aber echter Schmerzpunkt. Trainingsdaten für Roboter sind teuer, weil das Sammeln bedeutet, Roboter zu betreiben. Simulation ist günstig, erfordert aber normalerweise, dass jemand die Umgebung von Hand baut, was langsam ist und oft überhaupt nicht wie der reale Ort aussieht. Ein Modell, das einen echten Raum in eine Simulationsdatei verwandelt, fasst zwei teure Schritte zu einem zusammen. Das erklärt auch, warum Nvidia und AMD Investoren sind. Beide verkaufen die Rechenleistung, auf der Training und Simulation laufen.
Das Offenlegungsproblem
Es gibt eine Lücke zwischen dem Anspruch und der Dokumentationslage. World Labs hat zusammen mit Atlas kein Forschungspapier, keine Modellkarte, keine Parameteranzahl und keine Angabe zum Trainings-Compute veröffentlicht. Es wurden kein Preis und kein Datum für die allgemeine Verfügbarkeit genannt. Für ein System, das vergleichende Behauptungen gegenüber gut dokumentierten Wettbewerbern aufstellt, ist diese Auslassung ungewöhnlich, und sie machen die Blindtest-Ergebnisse unmöglich zu überprüfen.
Skeptiker haben eine schärfere Frage aufgeworfen: ob Atlas die Welt tatsächlich simuliert oder nur überzeugende Ansichten davon rendert. Das sind unterschiedliche Fähigkeiten, und die Unterscheidung ist wichtig für jeden Anwendungsfall, der auf Physik angewiesen ist. Ein Modell, das einen Raum aus einem neuen Winkel rendert, ist für einen Film nützlich. Ein Modell, durch das ein Roboter laufen lernt, braucht Objekte, die sich so verhalten, wie sich Objekte verhalten, sonst lernt die Policy etwas, das nur im Modell funktioniert.
World Labs sagt, Atlas werde künftige Versionen von Marble antreiben, seinem bestehenden Produkt. Das gibt ihm ein kommerzielles Zuhause, was mehr ist, als die meisten Forschungsankündigungen haben. Ob die Geometrie über kuratierte Demos hinaus standhält, werden die Early-Access-Partner zuerst erfahren.
Das chinesische Gegenstück
Atlas ist nicht das einzige Weltmodell mit einer stadtgroßen Ambition. Am 10. September veröffentlichte das chinesische Kartenunternehmen Amap ABot-Earth 0.7, das es als weltweit erstes 3D-natives Stadtweltmodell bezeichnet. Es nimmt Satellitenbilder oder eine Textbeschreibung und verwandelt sie in eine begehbare, interaktive 3D-Szene, die in einem einzigen Modell in mehreren Maßstäben von einem Planeten bis hinunter zu einem Wahrzeichen auf Straßenebene generiert. Amap sagt, es könne eine 3D-Stadtszene im Kilometermaßstab in etwa zehn Minuten auf einer Consumer-GPU im 3D-Gaussian-Splatting-Format erzeugen, und dass die Fähigkeit bereits in seinem Produkt Flight Street View läuft.
Die beiden deuten von entgegengesetzten Enden auf dieselbe Idee. Atlas arbeitet sich von einer Handvoll Fotos nach oben, rekonstruiert einen Raum mit hoher Wiedergabetreue. ABot-Earth arbeitet von Satellitendaten nach unten, generiert eine Stadt im Maßstab. Zusammen skizzieren sie die Bandbreite, die ein räumliches Modell abdecken kann, und sie zeigen auch, wie unterschiedlich die beiden Märkte ausliefern: das eine über ein Partnerprogramm ohne öffentliche Benchmarks, das andere eingebettet in ein Verbraucherprodukt, bei dem jeder die Ausgabe ansehen kann.
Was räumliche Modelle noch beweisen müssen
Das Feld hat Schwung. Metas V-JEPA 2 wurde mit mehr als einer Million Stunden Video trainiert. Googles Genie 2 generiert interaktive 3D-Umgebungen, und Gemini Robotics arbeitet an Reasoning und Manipulation im physischen Raum. Lis Argument, dass Geometrie und Perspektive dem Modell eigen sein müssen, statt aus Text abgeleitet zu werden, hat sich von einer Forschungsposition zu einer Produktkategorie entwickelt.
Was nichts davon geklärt hat, ist, ob ein Modell, das kohärente Geometrie erzeugt, dasselbe ist wie ein Modell, das einen physischen Raum versteht. Rekonstruktion ist messbar. Simulation ist schwieriger, und sie ist das, was die Robotik tatsächlich braucht. Atlas macht einen starken Fall für Ersteres. Die Partnerergebnisse des nächsten Jahres werden entscheiden, wie viel von Letzterem damit einhergeht.
Für Designer und Entwickler ist der kurzfristige Effekt bescheidener, als die Launch-Sprache nahelegt. Ein Werkzeug, das einen Raum aus drei Fotos rekonstruiert und einen eine Kamera durch ihn fliegen lässt, ist wirklich nützlich, und es wird eher in kreativer Software auftauchen als in einem Roboter. So erreichen räumliche Modelle die meisten Menschen zuerst: durch die Arbeit, eine Szene zu erschaffen, statt durch die Arbeit, eine zu navigieren.
Verwandte Artikel
Step 5 übersprang vier Versionsnummern, landete auf Platz zwei unter offenen Modellen – und niemand ruft es ab
Die Benchmark-Position ist ein Signal, das Produzenten nutzen, um ein Modell zu beurteilen. Das Aufrufvolumen ist ein Signal, das Nutzer durch seine Nutzung erzeugen.
Gemini Omni 1.1 Flash verkettete vier Anfragen zu einer 40-Sekunden-Aufnahme. Der Workflow ist das Produkt.
Google hat eine Produktionspipeline ausgeliefert, bei der ein Review-Gate in die Preisgestaltung eingebaut ist.
Microsoft senkt die Latenz für Teiltranskripte auf 100 Millisekunden. Das verändert, wofür Transkription da ist.
Unterhalb von 100 Millisekunden kann ein Transkriptionsprodukt reagieren, während jemand noch spricht.
Synthesia hat ein Jahrzehnt lang Avatare aufgezeichnet. Jetzt sollen sie zurücksprechen.
Ein Trainingswerkzeug, das Menschen freiwillig wiederholen, ist ein anderes Produkt als eines, das sie abschließen, weil es ihnen zugewiesen wurde.